AIFlux 3Black Forest Labs
Black Forest Labs เขย่าวงการ Flux 3 & Flux 3-Mimic AI เข้าใจฟิสิกส์จริง สร้างวิดีโอ + เสียงพร้อมกัน 20 วิ
โดย Thank Thanedpol6 ครั้งที่เข้าชม
โดย Thanedpol Dechaduangsakul | เผยแพร่: 24 กรกฎาคม 2569 | อ้างอิง: Black Forest Labs
สรุปสาระสำคัญ
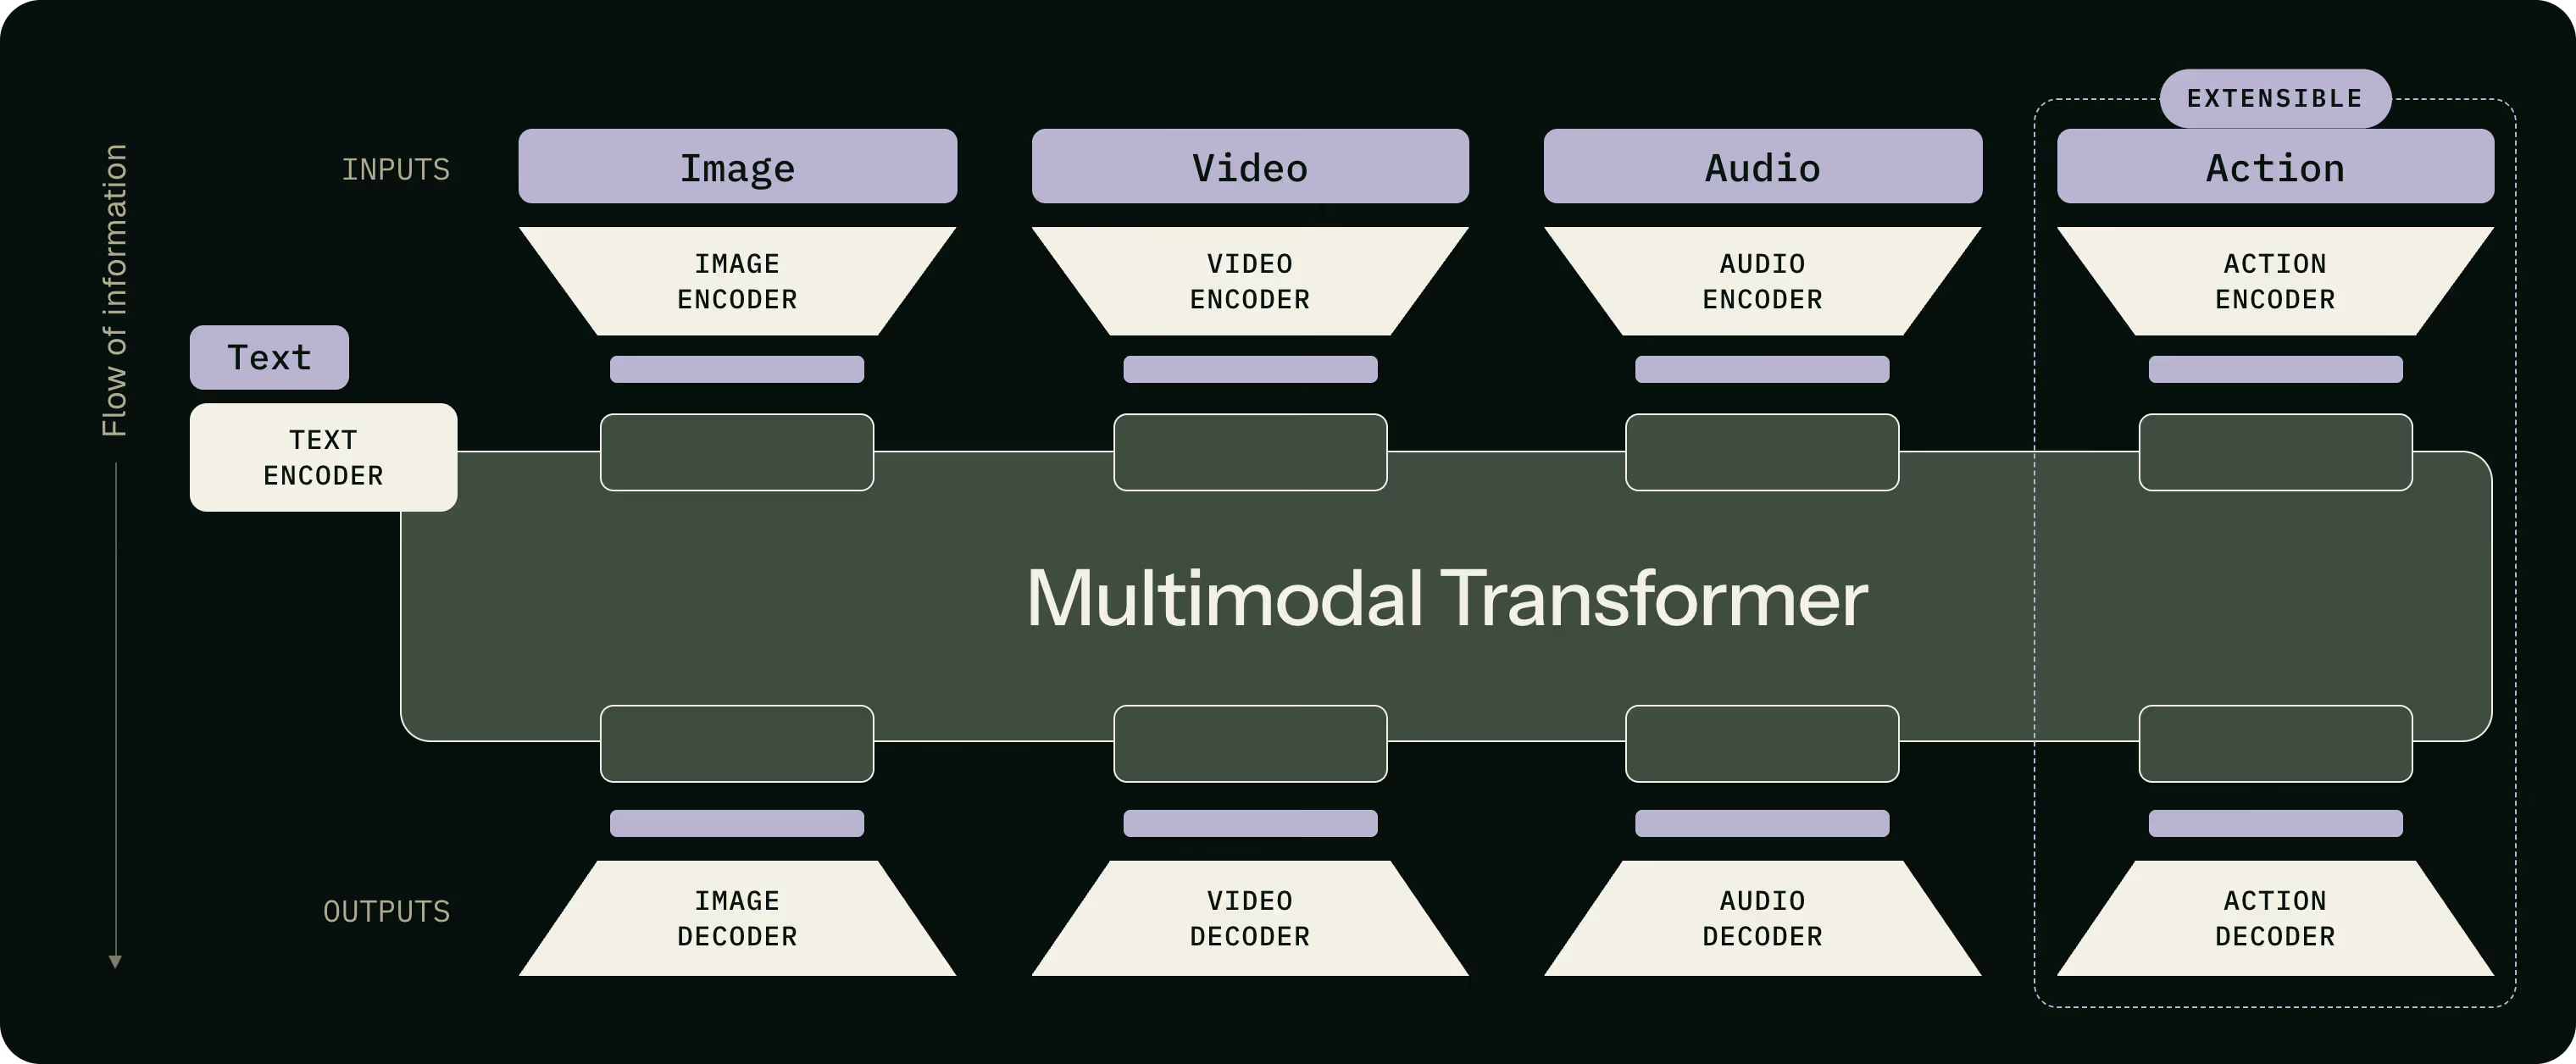
FLUX 3 เป็น multimodal foundation model ตัวแรกที่เรียนรู้จาก images, videos และ audio ไปพร้อมกันใน architecture เดียวกัน
สร้างวิดีโอพร้อมเสียงได้ยาวสูงสุด 20 วินาทีต่อการ generate หนึ่งครั้ง ชนะ Luma Ray 3.2 ในการเปรียบเทียบถึง 93%
พัฒนาต่อยอดเป็น FLUX-mimic ควบคุมหุ่นยนต์ในสายการผลิต Audi จริง จัดการชิ้นส่วนยืดหยุ่นที่ automation แบบเดิมทำไม่ได้
ใช้เวลา reaction time เพียง 101ms เร็วใกล้เคียงกับมนุษย์ และเรียนรู้งานใหม่ด้วยข้อมูลน้อยลงถึง 10 เท่า
ลองนึกภาพโมเดล AI ที่ไม่เพียงแค่สร้างภาพสวยๆ ได้ แต่เข้าใจว่าโลกนี้ทำงานยังไงจริงๆ วัตถุมีน้ำหนัก การเคลื่อนที่ต้องเป็นไปตามกฎฟิสิกส์ เสียงต้องตรงกับแรงกระแทก นี่คือสิ่งที่ FLUX 3 พยายามจะเป็นครับ
Black Forest Labs เพิ่งเปิดตัว FLUX 3 เมื่อ 23 กรกฎาคม 2026 ในฐานะ multimodal foundation model ที่เรียนรู้จาก images, videos และ audio พร้อมกันใน architecture เดียวกัน แนวคิดเบื้องหลังน่าสนใจมาก เขาบอกว่าไม่มี modality ไหนให้คำอธิบายที่สมบูรณ์ได้ Images จับโครงสร้าง ณ เวลาหนึ่ง Videos เพิ่มมิติเวลาและกฎฟิสิกส์ Audio เผยความสัมพันธ์เชิงเหตุผลระหว่างปรากฏการณ์กับเสียง ถ้าเรียนรู้จากทุกด้านพร้อมกัน ข้อจำกัดที่ทับซ้อนกันจะบอกเราได้มากกว่า
FLUX 3 ทำอะไรได้บ้าง?
สร้างวิดีโอพร้อมเสียงได้ยาวสูงสุด 20 วินาทีต่อการ generate หนึ่งครั้ง รองรับทั้ง text-to-video, image-to-video, video-to-video และ multilingual dialogue ผลการประเมินเบื้องต้นน่าตกใจ — FLUX 3 ชนะ Runway Gen-4.5 ในการเปรียบเทียบถึง 77% และชนะ Luma Ray 3.2 สูงถึง 93% แม้จะยังอยู่ในช่วง early access ก็ตาม
จุดแข็งที่โดดเด่นคือการจับสีหน้าการแสดงออกของมนุษย์ การเชื่อมโยงเสียงเข้ากับเหตุการณ์ทางกายภาพ และความสามารถด้านหลายภาษา ที่สำคัญคือสามารถสร้างลำดับภาพต่อเนื่องหลายนาทีโดยที่ตัวละครยังคงมีความสอดคล้องกันในทุกฉาก
แล้ว FLUX-mimic เกี่ยวข้องยังไง?
นี่คือส่วนที่ทำให้เรื่องนี้น่าสนใจกว่าแค่ข่าว AI สร้างวิดีโอธรรมดา FLUX 3 ไม่ได้หยุดอยู่ที่การสร้าง content แต่ถูกพัฒนาต่อยอดเป็น FLUX-mimic เพื่อควบคุมหุ่นยนต์ในสายการผลิตจริง
แนวคิดคือ ถ้าโมเดลเข้าใจว่าโลกทำงานยังไงจากการเรียนวิดีโอ มันก็ควรจะ predict การกระทำของหุ่นยนต์ได้ด้วย การ train FLUX 3 กินทรัพยากรกว่า 95% ไปกับ video prediction เพราะการจะสร้างวิดีโอที่สมจริง โมเดลต้องเรียนรู้ contact, motion, weight, cause และ effect ถ้าทำผิดแม้แต่อย่างใดอย่างหนึ่ง ผลลัพธ์ก็จะดูแปลกทันที
mimic robotics เข้าถึง FLUX 3 แบบ early access และร่วมกันพัฒนา FLUX-mimic ซึ่ง deploy จริงที่ Audi สำหรับจัดการชิ้นส่วนยืดหยุ่นอย่าง seals และ cables ที่ conventional automation ไม่เคยทำได้มาก่อน
ทำไมเรื่องนี้ถึงสำคัญ?
ตัวเลขที่น่าสนใจคือ FLUX-mimic ใช้เวลา reaction time เพียง 101ms เร็วใกล้เคียงกับ human visual reaction time และเรียนรู้งานใหม่ด้วยข้อมูลน้อยลงถึง 10 เท่าเมื่อเทียบกับ vision-language-action models รุ่นก่อนหน้า หุ่นยนต์ยังสามารถ recover จากความล้มเหลวได้เอง — ถ้าจับพลาด มันจะแก้ไขตัวเอง จับใหม่ และทำงานให้สำเร็จ โดยไม่ต้องมีการสาธิตการแก้ไขไว้ล่วงหน้า
Christoph Schneider จาก Audi Production Lab บอกว่า "เราเห็นหุ่นยนต์เหล่านี้แก้ปัญหาการจัดการ soft-body ที่ซับซ้อน ซึ่งเป็นไปไม่ได้เลยด้วย conventional robotics"
นี่ไม่ใช่แค่โมเดลสร้างวิดีโอที่เก่งขึ้น แต่เป็นการพิสูจน์ว่า foundation model เดียวกันสามารถทำได้ทั้งการสร้าง content และการควบคุมหุ่นยนต์ในโรงงานจริง
คำถามที่พบบ่อย
Q1: FLUX 3 ต่างจาก FLUX 1 และ FLUX 2 ยังไง?
A: FLUX 1 และ 2 สร้างได้แค่ images แต่ FLUX 3 เรียนรู้จาก images, videos และ audio พร้อมกันใน architecture เดียวกัน และสร้างวิดีโอพร้อมเสียงได้ยาวสูงสุด 20 วินาที
Q2: FLUX 3 เปิดให้ใช้งานหรือยัง?
A: FLUX 3 Video เปิดให้ใช้งานแบบ Early Access แล้ว ส่วน FLUX 3 Image จะเปิดในอีกไม่กี่สัปดาห์ข้างหน้า
Q3: FLUX-mimic ใช้กับหุ่นยนต์ยี่ห้อไหนได้บ้าง?
A: ปัจจุบันพัฒนาร่วมกับ mimic robotics และ deploy ที่ Audi แต่แนวคิดสามารถถ่ายโอนข้าม hardware ได้เพราะใช้ FLUX 3 backbone เป็นพื้นฐาน
Q4: ทำไม FLUX 3 ถึงควบคุมหุ่นยนต์ได้ทั้งที่ไม่ได้ถูก train มาสำหรับงานนั้น?
A: เพราะการ train ให้สร้างวิดีโอที่สมจริงบังคับให้โมเดลเรียนรู้ฟิสิกส์ของโลก — contact, motion, weight, cause และ effect ความรู้นี้ถูกเก็บไว้ใน feature representations ที่ action decoder สามารถ decode ออกมาควบคุมหุ่นยนต์ได้
Q5: FLUX 3 เร็วพอสำหรับงานจริงไหม?
A: backbone ของ FLUX-mimic รันจาก input ถึง world representation ได้ในไม่ถึง 80ms บน RTX 5090 GPU และระบบรวมมี reaction time 101ms เร็วใกล้เคียงกับมนุษย์
// อ่านต่อ
บทความที่เกี่ยวข้อง
AIPhysical AI
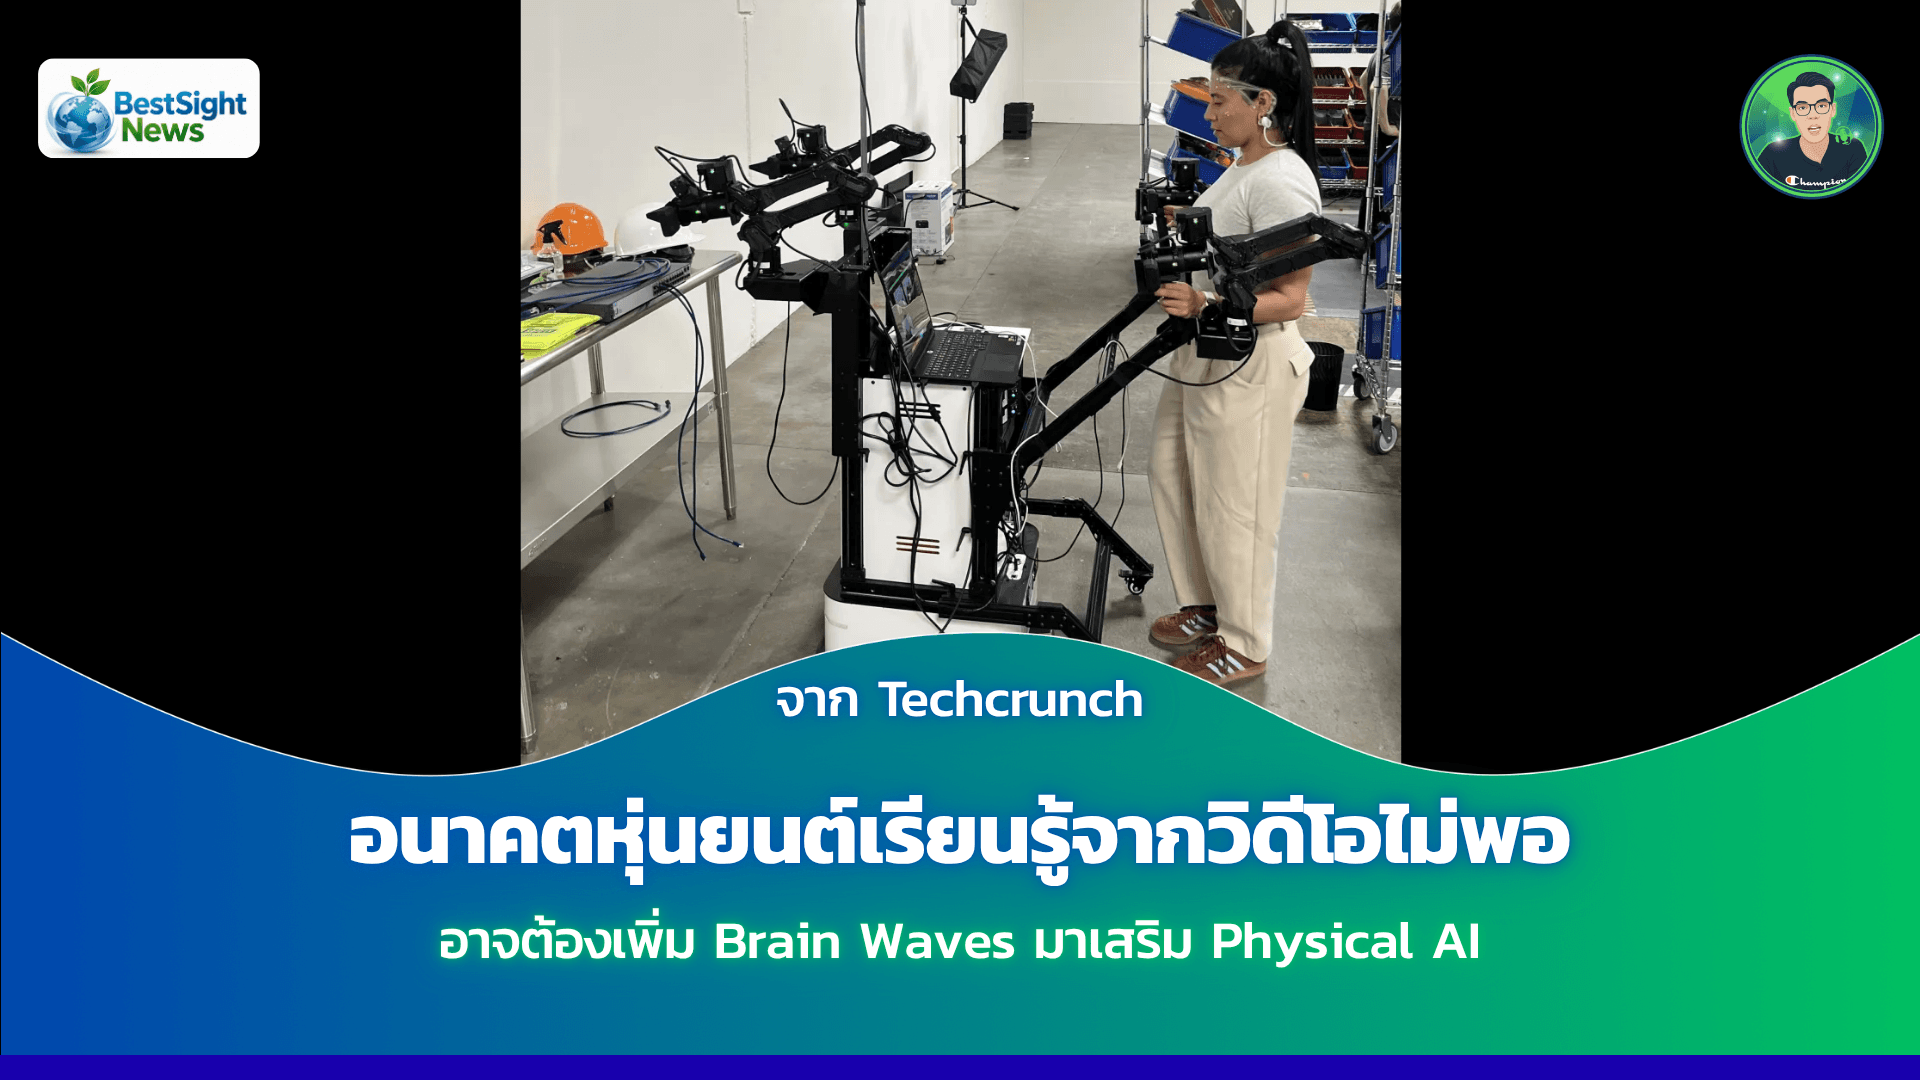
อนาคตหุ่นยนต์เรียนรู้จากวิดีโอไม่พอ อาจต้องเพิ่ม Brain Waves มาเสริม Physical AI
ข้อจำกัดใหม่ของวงการหุ่นยนต์และ Physical AI ไม่ใช่เรื่องโครงสร้างโมเดลหรือฮาร์ดแวร์ แต่เป็นการขาดแคลนข้อมูลการเคลื่อนไหวในโลกความจริง การให้หุ่นยนต์ดูวิดีโอว่าคนทำงานยังไงนั้นไม่เพียงพอ Startup อย่าง Encord จึงร่วมมือกับ Zander Labs ใช้หมวกวัดคลื่นสมองและสายวัดสัญญาณกล้ามเนื้อเพื่อจับความตั้งใจ ความผิดพลาด และระดับความยากของมนุษย์ขณะทำงานจริง ข้อมูลเชิงลึกนี้มีค่ามากกว่าวิดีโอทั่วไป 100 เท่า แม้ต้นทุนการผลิตจะสูงกว่า 20 เท่า ก็ถือเป็นราคาที่คุ้มค่าและกำลังเปลี่ยนโมเดลธุรกิจของการสร้างหุ่นยนต์ไปอย่างสิ้นเชิง
อ่าน →
AIชีวิตติด AI
15 เรื่องกับน้องกุ้ง OpenClaw, ระบบที่สร้างมาเพื่อกัน AI ตอนนี้กันไม่อยู่แล้ว
รายการ AI War Room ตอนที่ 3 จากช่องชีวิตติด AI ชวน ดร.บิ๊ก และคุณอั้นมาคาดการณ์ว่าในสงคราม AI ตอนนี้ ค่ายไหนกำลังจะขึ้นเป็นเจ้าตลาด เปิดเรื่องด้วยข่าวที่คุณอั้นบอกว่าถูกมองข้ามที่สุดในรอบสัปดาห์ — Claude เปิดฟีเจอร์ใหม่ชื่อ Claude Dispatch ให้สั่งงานผ่านมือถือแล้วให้ AI เข้าควบคุมหน้าจอคอมพิวเตอร์แทนเราได้ทุกอย่าง เดโมในรายการให้ Claude Dispatch ไปดึงราคาทองจาก CME พร้อม Sentiment นักลงทุนมาวิเคราะห์เป็นรายงานเอง ซึ่งเป็นงานที่ AI Agent ทั่วไปทำไม่ได้เพราะติดเรื่องสิทธิ์เข้าถึงข้อมูล
อ่าน →