AIBDIBDI Seminar 2026
AI ไทยมีข้อมูลแค่ 0.4% ของโลกกับแผนปฏิบัติการ AI ชาติ: มุ่งสู่ปี 2571 ด้วย 5 เสาหลัก
โดย Thank Thanedpol7 ครั้งที่เข้าชม
โดย Thanedpol Dechaduangsakul | เผยแพร่: 20 สิงหาคม 2569 | อ้างอิง: จากงาน BDI Seminar 2026
สรุปสาระสำคัญ
ข้อมูลภาษาไทยบนอินเทอร์เน็ตมีไม่ถึง 0.4% เทียบกับภาษาอังกฤษ 40% ต่างกันกว่า 100 เท่า
Claude ถูกระงับใช้งานนอกสหรัฐฯ ชั่วคราวเมื่อ 2 เดือนก่อน สะท้อนความเสี่ยงขององค์กรที่พึ่งพา AI เจ้าเดียว
คนไทยใช้ AI ส่วนตัว 12.4% แต่มีองค์กรที่จ่ายเงินใช้จริงจังเพียงราว 30% ต้นๆ
BDI เดินหน้าโปรเจกต์ ThaiLLM ฝึกโมเดลภาษาไทยขนาด 8 พันล้าน และ 3 หมื่นล้านพารามิเตอร์
สรุป Session: Sovereign AI: เทรนด์โลก ความท้าทาย และทิศทางประเทศไทย จากงาน BDI Seminar 2026 โดยคุณปฏิภาณ ประเสริฐสม, (รักษาการ) ผู้อำนวยการฝ่ายวิจัยและนวัตกรรม, สถาบันข้อมูลขนาดใหญ่ (องค์การมหาชน) — BDI
นิยาม AI Sovereignty คืออะไร
อธิปไตยด้าน AI คือ ความสามารถของประเทศหนึ่งๆ ในการควบคุมและใช้งาน AI ได้อย่างสะดวกและมีประสิทธิภาพ องค์ประกอบของมันไม่ได้มีแค่ตัวโมเดลที่เป็นปลายทางเท่านั้น แต่ต้องมองให้ครอบคลุมทั้งระบบ (Stack) ตั้งแต่รากฐานไปจนถึงปลายทางการใช้งานจริง
องค์ประกอบของ AI Sovereignty (The Stack)
1. โครงสร้างพื้นฐานไอที เช่น Data Center
2. พลังงาน ที่ใช้ขับเคลื่อนศูนย์ข้อมูลเหล่านี้
3. ข้อมูล (Data) ที่จำเป็นต่อการฝึกสอน AI
4. โมเดล (Model) ที่ผ่านการฝึกสอน
5. การประยุกต์ใช้งานจริง (Application)
บทเรียนจากเหตุการณ์ Claude
เหตุการณ์จริงเมื่อประมาณ 2 เดือนก่อน ที่ทำให้หลายคนเริ่มตื่นตัวกับเรื่อง AI Sovereignty มากขึ้น
Anthropic ปล่อยโมเดล Claude ที่มีศักยภาพสูงมาก จนรัฐบาลสหรัฐฯ ตัดสินใจ ระงับการใช้งานนอกประเทศชั่วคราว ส่งผลกระทบต่อผู้ใช้งานบางส่วนทันที เช่น นักพัฒนาเกมที่ต้องเปลี่ยนไปใช้โมเดลอื่นแทนกะทันหัน ก่อนผู้ให้บริการจะเปิดให้กลับมาใช้งานได้ตามปกติ
บทเรียน: แม้จะสลับไปใช้โมเดลอื่นที่ประสิทธิภาพใกล้เคียงกันได้ แต่ พฤติกรรมและการตอบสนองของแต่ละโมเดลไม่เหมือนกัน การเปลี่ยนกะทันหันอาจทำให้ระบบที่บูรณาการไว้ทำงานไม่ได้ตามคาดหวัง นี่คือ จุดเริ่มต้นของคำถามว่า เราจะควบคุมและจัดการปัจจัยเสี่ยงเหล่านี้ได้อย่างสมบูรณ์อย่างไร
ภาพรวมโลก ปี 2569: ตื่นตัว แต่ยังกระจุกตัว
แม้หลายประเทศจะเริ่มตื่นตัวและออกนโยบาย AI แห่งชาติ (National AI Policy) แต่ ศักยภาพที่แท้จริงในการใช้งาน AI ยังคงกระจุกตัวอยู่ในสหรัฐอเมริกาและจีนเป็นหลัก
อ้างอิง Stanford AI Index Report
• ช่วง 5 ปีที่ผ่านมา หลายประเทศเริ่มตื่นตัวจัดทำยุทธศาสตร์ AI ระดับชาติมากขึ้น
• โดยเฉพาะ 2-3 ปีหลัง ที่มีการใช้งาน LLM อย่าง ChatGPT แพร่หลาย ยิ่งเร่งให้เกิดการตื่นตัวเร็วขึ้น
• แม้แต่ ทวีปแอฟริกา หลายประเทศก็เริ่มออกแบบยุทธศาสตร์เพื่อสร้างบริบทของตนเองให้ชัดเจนยิ่งขึ้น
4 ปัจจัยชี้วัด AI Sovereignty ระดับโลก
เมื่อเจาะลึกในแต่ละระดับของ Stack จะเห็นแนวโน้มและจุดยืนของแต่ละประเทศชัดเจนขึ้น
โครงสร้างพื้นฐานการประมวลผลCompute Infrastructure
ไทย: ทรัพยากรและกำลังการประมวลผลสำหรับฝึกสอนโมเดลขนาดใหญ่ ยังมีไม่มากนัก นักพัฒนาหลายรายต้องแย่งชิงทรัพยากรกัน หรือไปเช่าใช้บริการจากต่างประเทศซึ่งมีราคาค่อนข้างสูง
โลก: การลงทุนจากภาครัฐเป็นดัชนีชี้วัดสำคัญ — จีนลงทุนมากที่สุด ด้วย Public-Private Supercomputing Center หลายแห่ง เช่น ที่เฉิงตู พร้อมอุดหนุนราคาให้ทั้งภาครัฐและเอกชนเข้าใช้งาน ขณะที่ภูมิภาคเอเชียโดยรวมยังลงทุนด้านนี้ค่อนข้างน้อย
ข้อมูล Data
เครื่องมือ: หลายประเทศเริ่มจากกฎหมายคุ้มครองข้อมูลส่วนบุคคล (GDPR ในยุโรป, PDPA ในไทย) เพื่อควบคุมว่าข้อมูลใดส่งออกนอกประเทศได้ และมาตรการ Data Localization ถูกใช้แพร่หลายในเอเชียและยุโรป
ข้อยกเว้น: สหรัฐอเมริกา เชื่อมั่นใน Free Data Flow การไหลเวียนข้อมูลอย่างเสรี โดยจำกัดเพียงห้ามส่งข้อมูลไปยังประเทศที่มองว่าเป็นกลุ่มเสี่ยงเท่านั้น
โมเดล Model
สถานะ: โมเดลหลักที่ใช้งานกันทั่วโลก มาจากสหรัฐฯ และจีนเป็นส่วนใหญ่ ปฏิเสธไม่ได้ว่าสองประเทศนี้เป็นผู้นำ
ทางออก: ยุโรปและเอเชีย (รวมถึงไทย) พยายามนำโมเดลเหล่านี้มา Fine-tune และ Localize ให้เข้ากับบริบทของประเทศตนเอง ขณะที่จีนพุ่งเป้าพัฒนาโมเดลของตนอย่างรวดเร็วเพื่อแข่งขันกับสหรัฐฯ โดยตรง
บุคลากร Talent
แนวโน้ม: การเคลื่อนย้ายบุคลากรด้าน AI (Talent Flow) ลดลงในทุกภูมิภาคทั่วโลก
ความหมาย: แต่ละประเทศ นำเข้าบุคลากรน้อยลง ส่งออกน้อยลง และพยายามเก็บรักษาบุคลากรด้าน AI ไว้ในประเทศของตนเองมากขึ้น
จุดยืนของไทย: ไทยควบคุมอะไรได้บ้าง?
เมื่อมองกลับมาที่ประเทศไทย นี่คือสถานะความสามารถในการควบคุมแต่ละองค์ประกอบของ Stack
ชิปและฮาร์ดแวร์: พึ่งพาการนำเข้า
ผู้ผลิตหลักของโลกมีเพียงสองฝั่งคือสหรัฐฯ และจีน แม้บางค่ายคลาวด์เริ่มผลิตชิปของตนเอง แต่ไทยยังไม่มีทางเลือกผลิตภายในประเทศมากนัก ต้องพึ่งพาการนำเข้าเป็นหลัก
โครงสร้างพื้นฐานการประมวลผล: บริหารจัดการเองได้
นำเข้าฮาร์ดแวร์มาติดตั้งและบริหารจัดการเอง ช่วยป้องกันไม่ให้ข้อมูลรั่วไหลออกนอกประเทศระหว่างการประมวลผลหรือฝึกสอนโมเดล
ข้อมูล: ควบคุมได้เต็มที่
โครงสร้างพื้นฐานด้านข้อมูลควบคุมได้อย่างสมบูรณ์ ผ่านกฎหมาย PDPA และระเบียบของหน่วยงานรัฐ
โมเดล: ต่อยอดจากต่างประเทศ
โมเดลส่วนใหญ่ในไทยเป็นการนำโมเดลพื้นฐานจากต่างประเทศมาต่อยอดและปรับบริบทให้เข้ากับประเทศไทย
การประยุกต์ใช้งาน: พัฒนา-ใช้เองในประเทศ
มีการพัฒนาและใช้งาน Application ภายในประเทศอย่างชัดเจน
มุมมองความคุ้มค่าการลงทุน
ข้อมูลเฉพาะทาง (Specific Data) คือ ปัจจัยสำคัญที่ทำให้แอปพลิเคชันและโมเดลเกิดประโยชน์สูงสุด ส่วน โครงสร้างพื้นฐานด้านการประมวลผล แม้ต้องใช้เงินลงทุนสูงมาก แต่ก็มีความสำคัญอย่างยิ่งเช่นกัน
กำลังคอมพิวเตอร์ภาครัฐไทย ณ วันนี้
2 แรงหลักที่ประเทศไทยมีอยู่ในมือ สำหรับรองรับงานด้าน AI
GDCC: โครงสร้างพื้นฐานคลาวด์ของรัฐ ให้บริการคลาวด์ทั่วไป และพยายามนำ GPU เข้ามาให้บริการมากขึ้นเรื่อยๆ
LANTA @ สวทช. : ซูเปอร์คอมพิวเตอร์ภาครัฐสำหรับการฝึกสอนโมเดลโดยเฉพาะ ซึ่ง เพิ่งได้รับการอัปเกรดประสิทธิภาพการทำงาน
โครงการ ThaiLLM โดย BDI
ริเริ่มโดย BDI ด้วยทุนสนับสนุนจากกองทุนพัฒนาดิจิทัลเพื่อเศรษฐกิจและสังคม (กองทุน DE) เพื่อสร้างโมเดล AI ที่เข้าใจบริบทของประเทศไทยมากยิ่งขึ้น
NECTEC
VISTEC
สมาคม AIEAT
ม.มหิดล
จุฬาลงกรณ์มหาวิทยาลัย
สัดส่วนข้อมูลบนอินเทอร์เน็ต
ภาษาอังกฤษ ~40% & ภาษาไทย <0.4%
100x ต่างกันกว่า 100 เท่า — แต่โมเดลหลายตัวก็ยังใช้ภาษาไทยได้ดี
ทำไมบริบทท้องถิ่นถึงสำคัญ
เมื่อต้องตอบคำถามที่อาศัยบริบทเฉพาะของไทย หรือกระบวนการตามกฎหมายไทยที่ซับซ้อน โมเดลต่างชาติอาจยังทำได้ไม่ดีนัก
ตัวอย่าง: เมื่อก่อน AI วิเคราะห์ภาพ "การก่อพระเจดีย์ทราย" ไม่ได้ เพราะไม่เข้าใจบริบทวัฒนธรรมไทย — วันนี้ AI พัฒนาไปมาก จนอธิบายได้ว่านี่คือ ประเพณีขนทรายเข้าวัดเพื่อการบูรณปฏิสังขรณ์
ขั้นตอนการพัฒนา Foundation Model
รวบรวมข้อมูลภาษาไทย
จากอินเทอร์เน็ต และข้อมูลที่ได้รับบริจาคจากหน่วยงานพันธมิตร
คัดกรองและปรับสัดส่วน
ผ่านกระบวนการคัดกรองและปรับสัดส่วนข้อมูลให้เหมาะสม
ฝึกสอน Foundation Model
ขนาด 8 พันล้าน (8B) และ 30 พันล้าน (30B) พารามิเตอร์
ต่อยอดสู่การแพทย์ — ร่วมกับศิริราชพยาบาล
Fine-tune โมเดลร่วมกับ คณะแพทยศาสตร์ศิริราชพยาบาล เพื่อคัดกรองผู้ป่วยเบื้องต้น (Pre-screening)
ซักประวัติ
สร้างโปรไฟล์ผู้ป่วย
แนะนำการดูแลตัวเองเบื้องต้น
ประเมินความเร่งด่วนของอาการ
ช่วย ลดระยะเวลาการรอคอย ของคนไข้ก่อนเข้าพบแพทย์
ประสานงานกับ Ecosystem โมเดลไทย
ประสานงานกับผู้พัฒนาโมเดล Open Source ไทย เพื่อปรับแต่งให้ตอบโจทย์บริบทธนาคารและองค์กรธุรกิจ
Typhoon
Pathumma
OpenThaiGPT
ThaiLLM Playground: เว็บไซต์เปิดให้ผู้สนใจทดลองใช้งานโมเดลที่พัฒนาขึ้น (โมเดลขนาดเล็กจากข้อจำกัดด้านงบประมาณ) พร้อม API Key สำหรับนำไปพัฒนาต่อยอด รวมถึงมีระบบแชตบอตทางการแพทย์เบื้องต้นให้ทดลองใช้งาน
* ฟีเจอร์การวินิจฉัยโรคต้องผ่านกระบวนการตรวจสอบและรับรองตามกฎหมายทางการแพทย์ก่อนเปิดใช้งานจริง
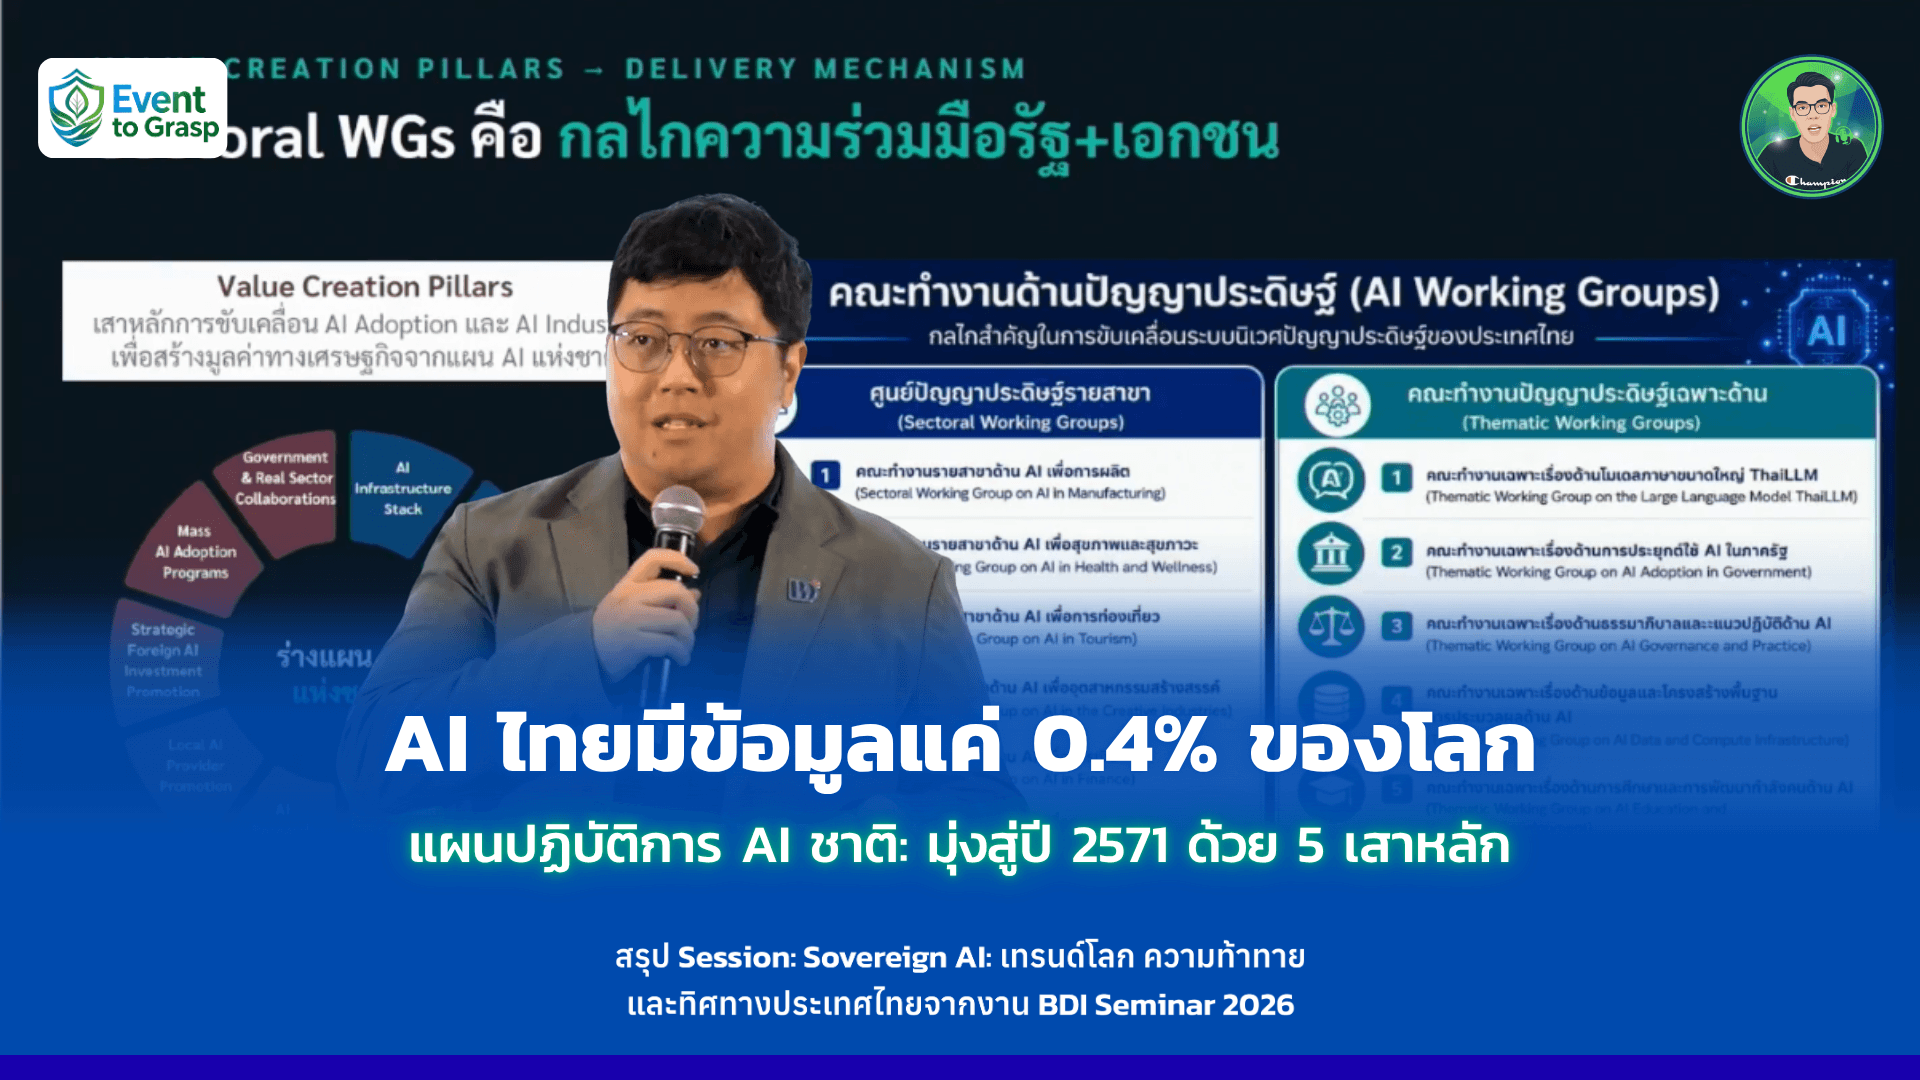
แผนปฏิบัติการ AI ชาติ: มุ่งสู่ปี 2571
ประเทศไทยกำลังร่างแผนปฏิบัติการด้าน AI ระยะต่อไป (เริ่มปี 2571) ยังอยู่ระหว่างการปรับปรุง แต่แนวคิดหลักคือการผลักดันให้เกิดการนำ AI ไปใช้งานจริงให้มากขึ้น
แผนเดิมตั้งแต่ปี 2565 — 5 เสาหลัก
1. จริยธรรมและธรรมาภิบาล (Ethics & Governance)
2. โครงสร้างพื้นฐาน (Infrastructure)
3. การพัฒนาบุคลากร (Talent)
4. การวิจัยและพัฒนา (R&D)
5. การส่งเสริมการใช้งานภาคธุรกิจ (Business Adoption)
ความคืบหน้าที่เกิดขึ้นแล้ว
คู่มือ AI Governance โดย ETDA
โครงสร้างพื้นฐาน LANTA
โครงการ Super AI Engineer ที่ช่วยสร้างบุคลากรด้าน AI เข้าสู่ตลาดแรงงาน
12.4% บุคลากรไทยใช้งาน AI ระดับบุคคล (อ้างอิง Microsoft)
~30%+ องค์กรที่ยอมรับและจ่ายเงินใช้ AI อย่างจริงจัง
ความท้าทายที่ทำให้ Adoption ยังไม่สูง
ความคุ้มค่าในการลงทุน
ความพร้อมของข้อมูล
ความกังวลด้านความปลอดภัยของข้อมูล
ทิศทางแผนระยะถัดไป
มุ่งเน้นไปที่การสร้างมูลค่า (Value Creation) และการส่งเสริมการใช้งาน (Adoption) อย่างเป็นรูปธรรม โดยแบ่งคณะทำงานระดับชาติออกเป็น 2 กลุ่ม:
Sectorial — ส่งเสริมการใช้งานรายอุตสาหกรรม ครอบคลุม 7 ภาคส่วนสำคัญ
Thematic — สนับสนุนภาพรวมด้านโครงสร้างพื้นฐาน บุคลากร กฎหมาย และการพัฒนาโมเดลภาษาขนาดใหญ่ เพื่อบูรณาการที่ครอบคลุมทุกมิติ
คำถามที่พบบ่อย (FAQ)
Q: Sovereign AI ต่างจาก AI ทั่วไปยังไง
A: เน้นที่ใครควบคุมได้ ทั้งโครงสร้างพื้นฐาน ข้อมูล และโมเดล ไม่ใช่แค่เรื่องความฉลาดของ AI
Q: ทำไมข้อมูลภาษาไทยถึงน้อยขนาดนี้
A: เพราะเนื้อหาบนอินเทอร์เน็ตส่วนใหญ่เป็นภาษาอังกฤษเกือบ 40% ขณะที่สัดส่วนเนื้อหาภาษาไทยในระดับโลกยังน้อยกว่ามาก
Q: ThaiLLM ใช้งานได้แล้วหรือยัง
A: ทดลองได้ผ่าน ThaiLLM Playground ส่วนฟีเจอร์ทางการแพทย์อย่างการวินิจฉัยยังต้องรอการรับรองตามกฎหมายก่อน
Q: องค์กรทั่วไปเริ่มต้นเรื่องนี้ยังไงดี
A: เริ่มจากประเมินว่าตอนนี้พึ่งพาโมเดลหรือระบบต่างประเทศเจ้าเดียวมากแค่ไหน แล้ววางแผนสำรองไว้ล่วงหน้า
ข้อสรุป:
แล้วองค์กรของคุณอยู่จุดไหน?
ไม่ว่าองค์กรของคุณจะอยู่จุดใด ก็สามารถเลือกปรับตัวให้เข้ากับแนวทางที่เหมาะสมได้
เริ่มต้นทดลองใช้งาน: เพื่อเพิ่มประสิทธิภาพการทำงานของบุคลากร
ลงทุนในโครงสร้างพื้นฐาน: สร้างขีดความสามารถด้านการประมวลผลของตนเอง
เตรียมพร้อมขยายบริการสู่สากล: ขยายบริการ AI ของไทยออกสู่ตลาดสากล
เพื่อสร้าง เศรษฐกิจ AI ที่เติบโตได้อย่างยั่งยืน ให้กับประเทศไทยต่อไป
Source:
จากงาน BDI Seminar 2026
// อ่านต่อ